MACHINES
Nvidia vous vend la moitié d’une RTX 4090
Un module Linux libère la moitié bridée de la RTX 4090, et le web crie au scandale. Sur le papier, ×2. Dans vos logiciels, bien moins.
Le 25 octobre, Hardware Busters titre que la RTX 4090 « double » son débit de calcul. Pas grâce à une nouvelle puce, pas grâce à un nouveau pilote, non : grâce à un petit module† Linux libre, gpu-unlock-ada. Depuis, la nouvelle fait le tour de la presse spécialisée, et le web a déjà rendu son verdict : Nvidia vend aux joueurs la moitié d’une carte et garde l’autre pour ses cartes professionnelles, bien plus chères.
Voilà la version qui circule. Sauf qu’elle oublie un détail.
Et ce détail, c’est Nvidia lui-même qui l’a imprimé.
« Une seule paire de mesures, bureau actif : ni des gains sur des applications entières, ni un test de stabilité prolongé. »
— JustAResearcher, auteur de gpu-unlock-ada (traduit de l’anglais)
Pour répondre au titre sans détour, disons que le bridage existe : Nvidia l’imprime même dans le livre blanc de son architecture Ada. Et c’est là que l’histoire devient savoureuse. Parce que de deux choses l’une : soit Nvidia vous cachait la moitié de votre carte, soit il l’écrivait noir sur blanc.
Réponse : il l’écrivait. Annexe A, en toutes lettres. Pris la main dans le sac, oui, mais dans un document qu’il a lui-même publié. Et ça ne date pas d’hier. 2080 Ti, 3090 Ti, 4090 : trois générations, et toujours la même moitié…
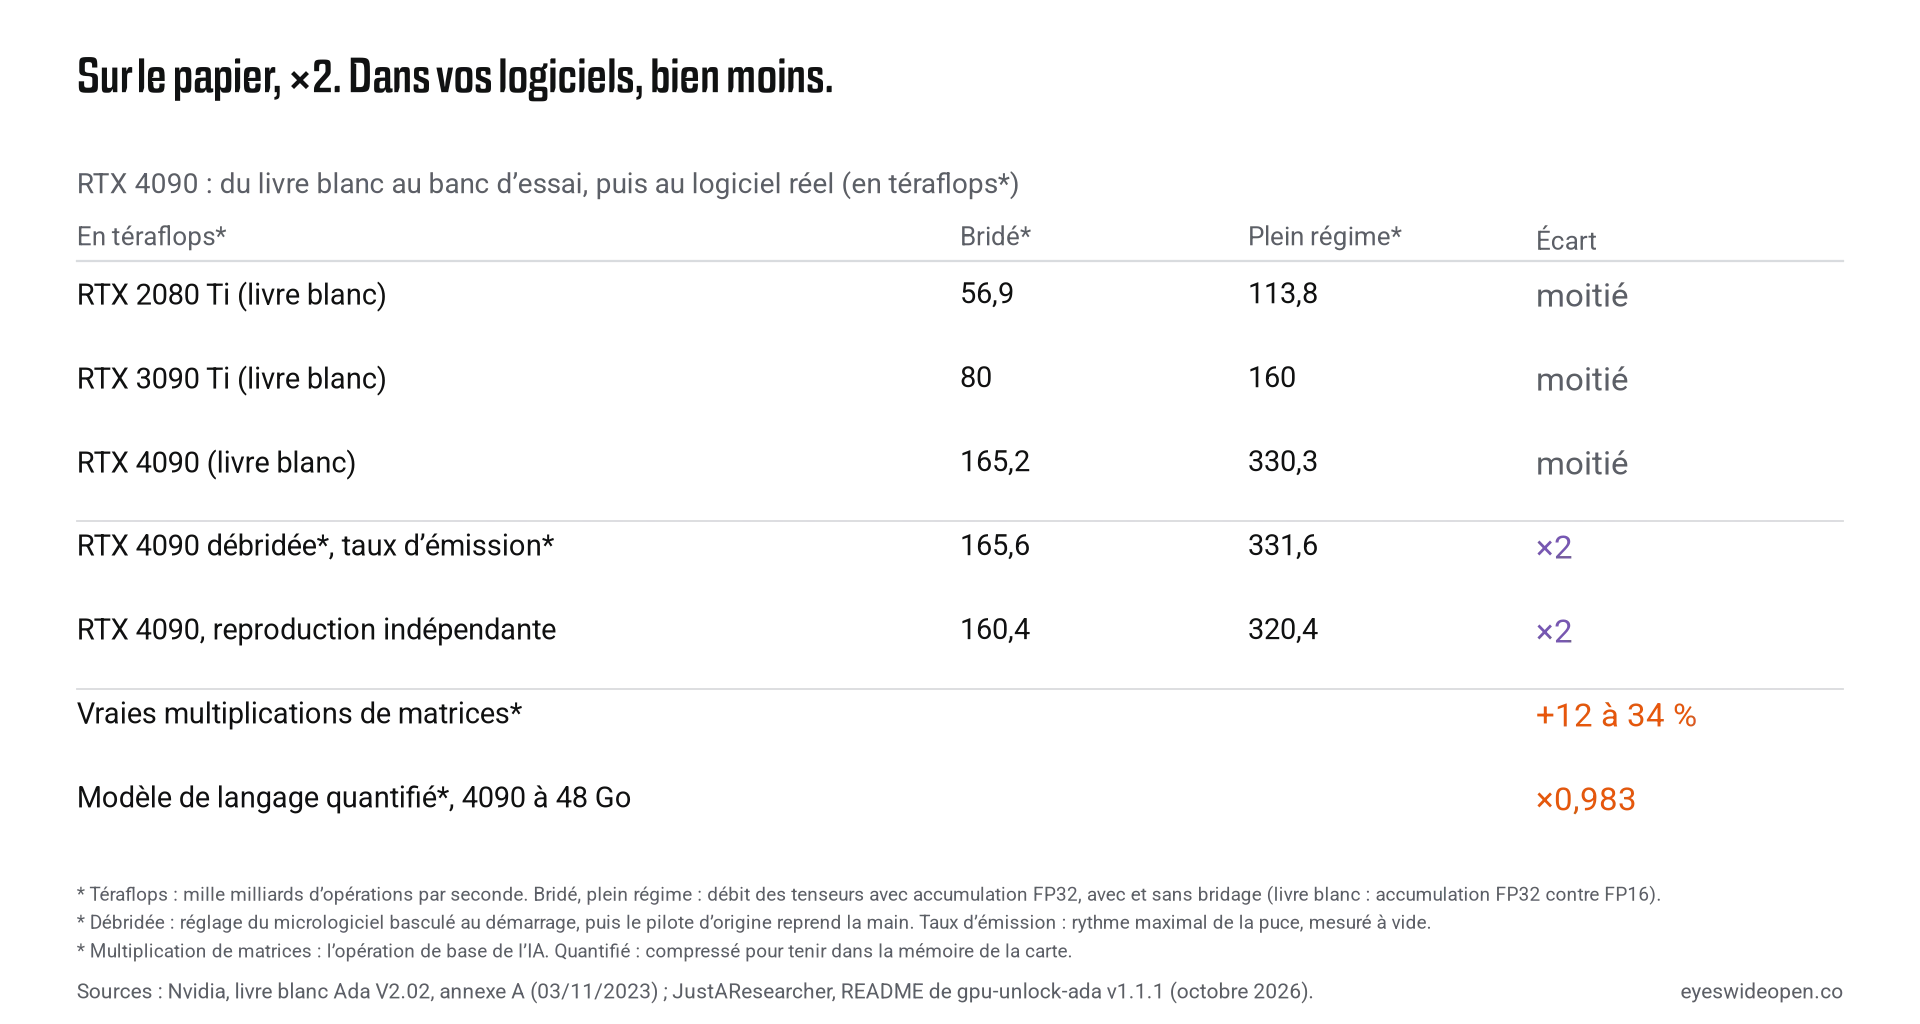
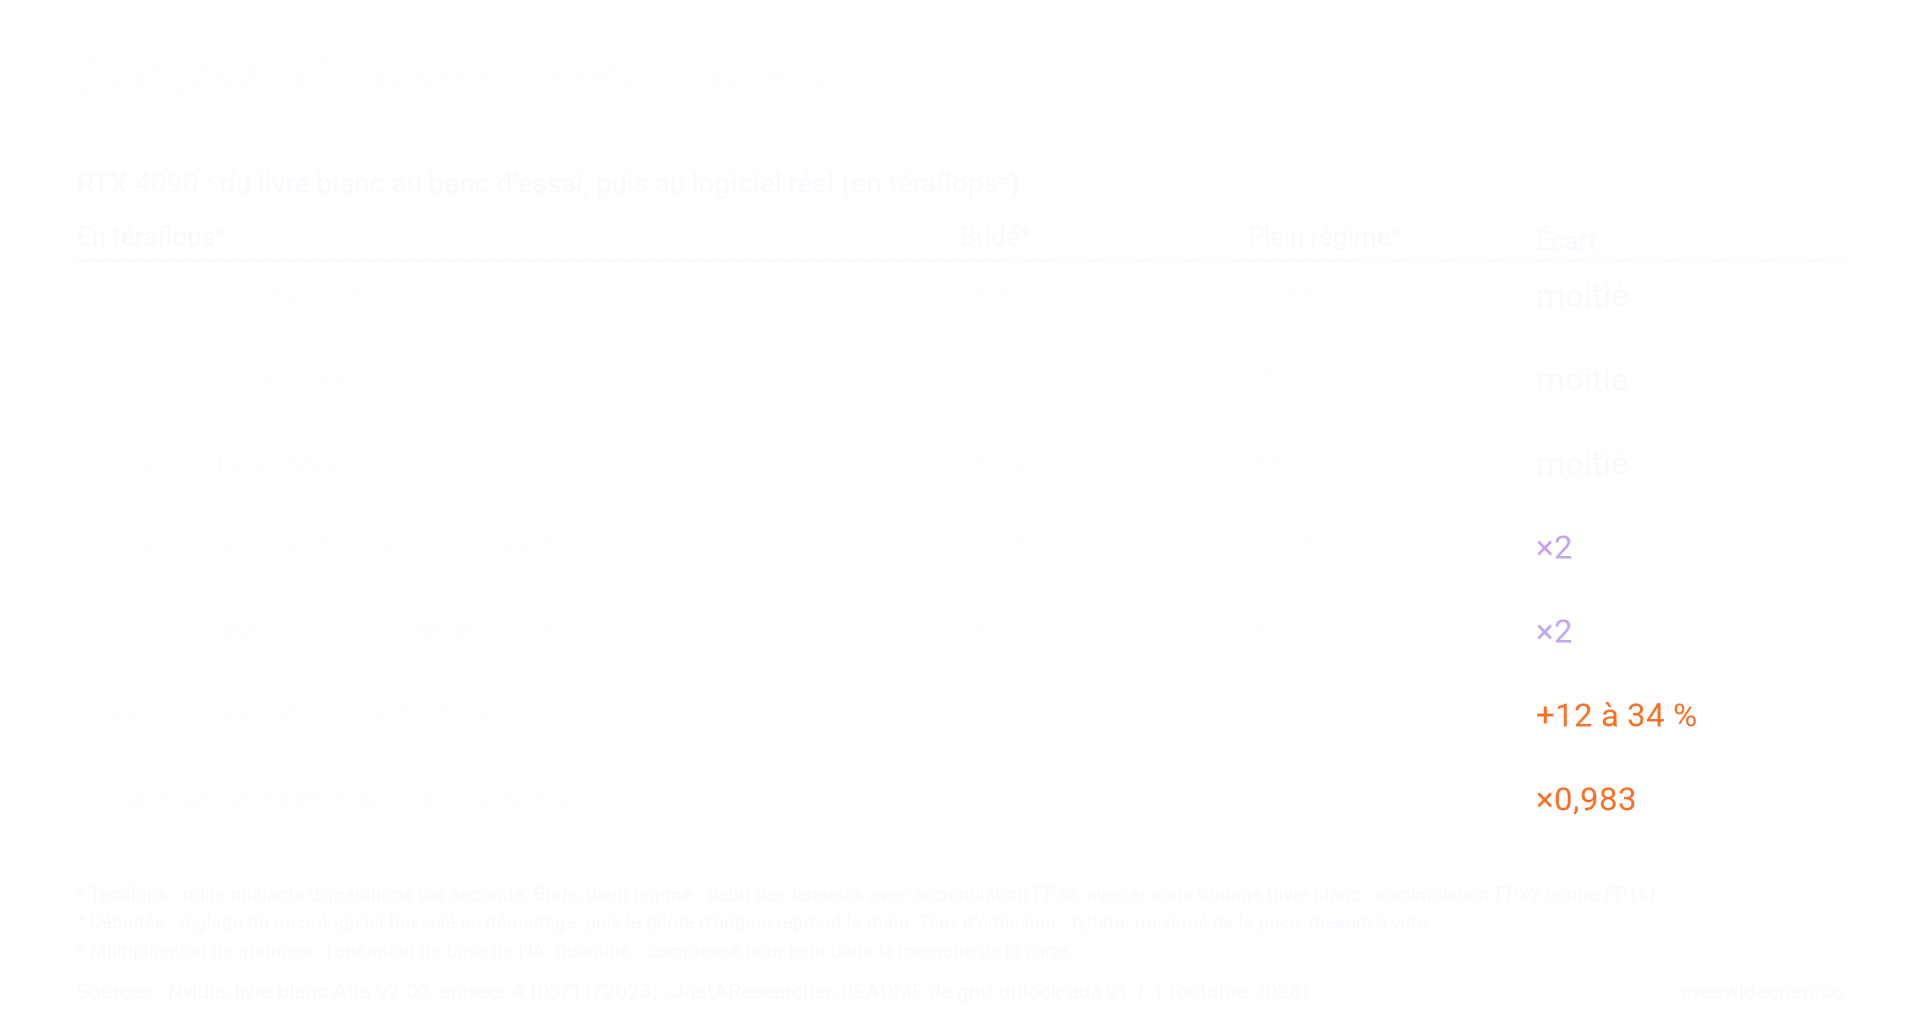
Alors maintenant, les lignes 4 et 5 du tableau, et c’est là que ça se gâte pour la belle histoire. Sur la carte de l’auteur du module, le ×2 est bien là. Une reproduction indépendante le confirme. Jusqu’ici, tout va bien. Sauf que lisez les petites lignes du repo‡ : ce sont des taux d’émission, pas des accélérations dans vos applications. Et ce n’est pas moi qui le dis, c’est l’auteur du module. Dans de vraies multiplications de matrices, le gain retombe entre 12 et 34 %. Autrement dit, le ×2 existe sur le banc d’essai. Dans vos logiciels, beaucoup moins.
Et la promesse qui va avec, faire tourner chez soi ses modèles d’IA deux fois plus vite ? Vous savez ce que ça donne, sur un modèle de langage, avec une 4090 gonflée à 48 Go ? 0,983. Traduction : aucun gain. Même un poil en dessous. Deux fois plus de puissance sur le papier, et sur ce test, on recule.
Il faut avouer que ça calme. Les gagnants, selon Hardware Busters, sont ailleurs : la génération d’images, l’affinage§, l’entraînement. Le tout sous Linux seulement, à vos risques, et avec 346 watts au pic au lieu de 313.
Alors, que le calcul soit bridé, je ne vais pas vous dire le contraire. Mais le scandale, je n’y crois pas une seconde. On ne crie pas au complot devant un document que l’accusé a lui-même publié. Pour héberger ses propres modèles d’IA, en définitive, je ne pense pas que ça change grand-chose, ou du moins de façon négligeable. Rendez-vous fin janvier 2027 : aucun banc d’essai indépendant n’y verra plus de 20 % de gain. Parce que la vraie frontière entre le joueur et le pro, ce n’est pas le calcul. C’est la mémoire.
Le calcul, un registre‖ suffit à le libérer.
Les 24 Go de la 4090, aucun registre ne les double.
Cela dit, si cet article vous a donné envie de débrider votre carte graphique, ce n’est pas moi qui vous en dissuaderai. À vos risques et périls, évidemment.
†module (noyau Linux) : petit programme que le système charge pour piloter un matériel ; ici, il modifie un réglage de la carte avant que le pilote d’origine ne démarre.
‡repo (repository) : dossier de projet hébergé sur GitHub, où l’auteur d’un code publie ses fichiers et son mode d’emploi (le « README »).
§affinage (fine-tuning) : ré-entraîner légèrement un modèle existant sur ses propres données.
‖registre : petite case mémoire interne d’une puce, où l’on inscrit un réglage.
Source :JustAResearcher — dépôt GitHub gpu-unlock-ada (README, v1.1.1), octobre 2026